長い文章を読むとき、私たちはすべての単語を同じようには扱っていない。少し前に出てきた主語を思い出したり、遠くにある言葉とのつながりに気づいたりする。
Attentionを理解する入口として、まずは「いまの言葉を理解するために、ほかのどの言葉を参照するか」という問いを置いてみる。
まず、論文の位置づけをつかむ
Vaswaniらの論文は、再帰や畳み込みを使わず、Attentionを中心に組み立てたTransformerを提案した。機械翻訳の実験を通して、品質と並列化のしやすさを示している。
この記事では全体の実装には踏み込まず、その核になるAttentionの直感をつかむことを目標にする。
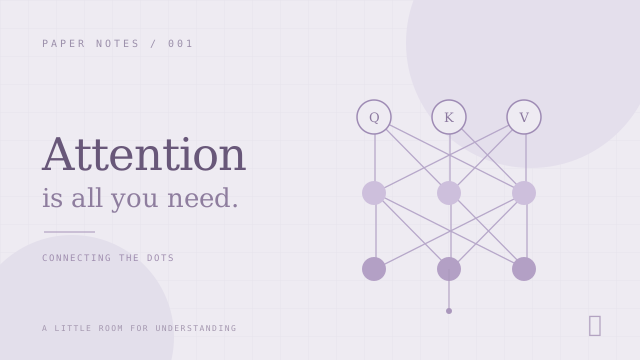
Query・Key・Valueを、図書館で考える
図書館で調べものをする場面を想像する。知りたいことがQuery、本を探す手がかりがKey、見つけた本から得る内容がValue。これは理解のためのたとえで、実際のモデルではいずれもベクトルとして扱う。
- Query(Q):何を知りたいか。
- Key(K):どれだけ関連があるかを比べる手がかり。
- Value(V):関連度に応じて集める情報。
数式は「重みをつけて集める」
Scaled Dot-Product Attentionの形は、次のように表せる。
まずQとKで関連度を計算し、スケールを調整する。softmaxで重みに変換してから、その重みでVを集める。記号を一つずつ追うと、やっていることは「どの情報を、どれくらい参照するか」に近づいてくる。
理解は、まだ途中でいい
一つの式が読めるようになったら、次はMulti-Head Attentionや位置情報の扱いへ進めばいい。論文全体を一度に理解するより、一つの疑問を持ち帰れる読み方を大切にしたい。
式を眺めるだけでなく、「この計算は、何を決めているんだろう」と言葉にしてみる。
読んだもの
Vaswani et al., Attention Is All You Need(2017)。本記事のたとえは、理解のために独自に付け加えたものです。